

レガシーシステムとの作業は、地図なしで迷路を歩くようなものによく似ています。コードの行はありますが、その背後にある構造を理解するのは非常に困難な作業になることがあります。ここで「UML リバースエンジニアリング」が役立ちます。これは生きたコードを視覚的な表現に変換するもので、特に「UML クラス図」を作成し、複雑なロジックをアクセス可能で理解しやすいものにします。
このガイドでは、コードを構造化された図形に変換するプロセスを詳しく解説します。その仕組み、パターン、そして実践的な手順を探求していきます。最後に、推測に頼らずにオブジェクト指向の構造を可視化する方法を理解できるようになるでしょう。それでは、詳細を見ていきましょう。
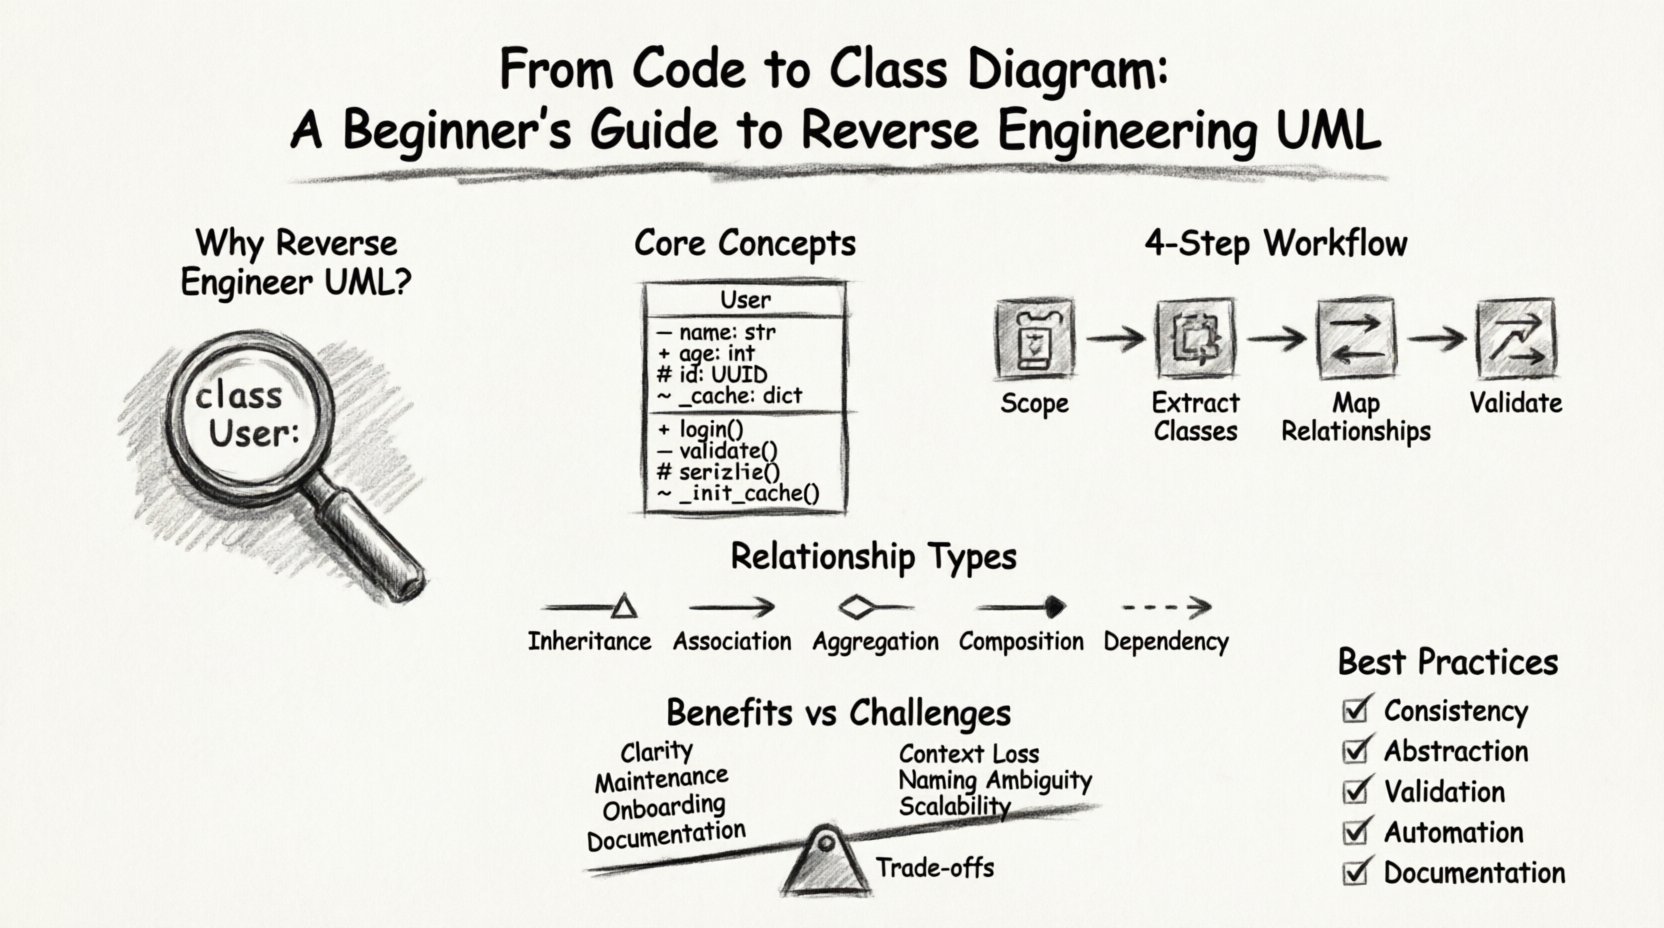
UML の文脈におけるリバースエンジニアリングとは何ですか?🤔
ソフトウェア開発におけるリバースエンジニアリングは、システムの構成要素とその相互関係を特定するためにシステムを分析するプロセスです。これを「統一モデリング言語(UML)」に適用する場合、ソースコードからモデルを導き出すことを意味します。まずコードを書いてから図を描く(フォワードエンジニアリング)のではなく、実装から始めて設計を抽出します。
なぜこれが必要なのでしょうか?多くの場合、ドキュメントがコードと同期しなくなります。チームが成長し、機能が変更されると、元の図は時代遅れになります。リバースエンジニアリングは、実装と設計の間のリンクを回復します。
- 明確さ:視覚的な図は、テキストよりもはるかに速く関係性を説明します。
- 保守:依存関係を理解することは、リファクタリングに役立ちます。
- オンボーディング:新しい開発者は、システムアーキテクチャをより早く理解できます。
- ドキュメント:現在の状態の最新記録を作成します。
基本概念:構成要素の理解 🧱
プロセスに飛び込む前に、クラス図」を構成する要素が何かを理解する必要があります。これらの図は、システムの静的構造を表します。コード内のすべての要素は、モデル内にそれに対応する表現を持ちます。
1. クラスとオブジェクト
クラスはオブジェクトを作成するための設計図です。リバースエンジニアリングでは、型定義を探すことでクラスを特定します。多くの言語では、これらは明示的なキーワードです。他の言語では、使用パターンから推測されます。
- クラス名:通常、ファイル名または主要な識別子と一致します。
- 属性:クラススコープ内で宣言された変数。
- メソッド:そのクラスに属する関数または手順。
2. 可視性と修飾子
クラスのすべてのメンバーがどこでもアクセスできるわけではありません。UMLでは、可視性を示すために特定の記号を使用します。これらを理解することは、正確な図面作成に不可欠です。
| 記号 | 可視性 | コードの対応 |
|---|---|---|
| + | パブリック | public / デフォルト |
| – | プライベート | private |
| # | プロテクト | protected |
| ~ | パッケージ/フレンド | internal / パッケージプライベート |
3. 型とデータ構造
属性には型があります。図面では、これは属性名の隣に表示されます。プリミティブ型と参照型の区別は、データフローを理解する上で極めて重要です。
- プリミティブ:int, boolean, string。単純な値。
- 参照:オブジェクト、インターフェース、または他のクラス。これらは接続を作成します。
ステップバイステップのワークフロー 🚀
コードを図に変換する即座にはできません。体系的なアプローチが必要です。以下は、手動または自動化ツールで分析を行うための論理的なフローです。
ステップ1: 棚卸しとスコーピング 📋
境界を定義することから始めます。単一のモジュール、ライブラリ、それともアプリケーション全体を分析していますか?スコーピングを設定することで、図が読み取り不可能なほど大きくなるのを防ぎます。
- すべてのエントリポイント(メイン関数、コントローラー)をリストアップする。
- 中核となるドメインを特定する(例:ユーザー、注文、製品)。
- ノイズを減らすため、可能な限り外部依存関係を除外する。
ステップ 2:クラス抽出 🧩
これが中核的なタスクです。コードベースをスキャンして定義を見つけます。
- 定義の特定: 次を探す:
class,interface、またはstructキーワード。 - メンバーの抽出:これらの定義内のすべての変数とメソッドを抽出する。
- 分類:静的メンバーとインスタンスメンバーを分離する。
ステップ 3:関係マッピング 🔗
クラスは孤立して存在することはめったにありません。クラスは相互作用します。あるクラスが別のクラスをどのように使用するかを特定する必要があります。
- インスタンス化:クラス A がクラス B のインスタンスを作成する場合、リンクが存在します。
- メソッドの引数:メソッドがクラス C を引数として受け取る場合、依存関係が存在します。
- 戻り値の型:メソッドがクラス D を返す場合、関係が存在します。
- 継承: 次を探す:
extends、またはimplementsキーワード。
ステップ 4: 検証とクリーンアップ 🧹
初期の抽出にはノイズが含まれていることがよくあります。モデルを洗練させる必要があります。
- 構造に影響を与えない実装の詳細を削除してください。
- 設計上の欠陥を示す可能性のある循環依存関係を確認してください。
- 図全体で命名規則が統一されていることを確認してください。
関係性の深掘り 🔍
関係性の理解は UML リバースエンジニアリングで最も重要な部分です。関係性のないクラス図は単なるクラスのリストに過ぎません。接続がシステムの物語を語ります。
1. 継承(一般化)🌳
これは「is-a(~である)」関係を表します。特定の子クラスは、より一般的な親クラスから継承されます。コード上では、これは明示的な構文です。
- 視覚的表現:親クラスを指す実線の線に、中空の三角形の矢印が付いています。
- コード:
class Child extends Parent. - 意味合い:子クラスは親クラスのすべての属性とメソッドを継承します。
2. 関連 💼
関連とは、オブジェクトが接続されている構造的な関係です。あるオブジェクトが別のオブジェクトを参照する場合、これがデフォルトの関係となります。
- 視覚的表現:2 つのクラスを結ぶ実線の線です。
- コード:あるクラス内のフィールドが、別のクラスへの参照を保持しています。
- 多重度:1 対 1 ですか?1 対多ですか?多対多ですか?
3. 集約と合成の違い 🧱
これらは所有権とライフサイクルに関する特定の種類の関連です。
| 種類 | 意味 | 視覚的記号 | コード例 |
|---|---|---|---|
| 集約 | 全体と部分の関係。部分は独立して存在できる。 | 空のダイヤモンドが付いた線 | クラスAは、クラスBのインスタンスを引数として受け取る。 |
| 合成 | 強い所有権。部分は全体なしでは存在できない。 | 塗りつぶされたダイヤモンドが付いた線 | クラスAはクラスBを内部で生成し、破棄する。 |
4. 依存関係 📉
依存関係はより弱い関係である。あるクラスの変更がもう一方に影響を与える可能性があるが、両者は恒久的に結びついているわけではない。
- 視覚的表現: 開いた矢印付きの点線。
- コード: メソッドのパラメータ、ローカル変数、または静的メソッド呼び出し。
- 使用例: クラスAは、タスクを実行するためにクラスBを一時的に使用する。
複雑なシナリオへの対応 🏗️
実際のコードベースは複雑である。逆エンジニアリングを困難にするパターンが含まれている。一般的な課題への対処法を以下に示す。
1. インターフェースと抽象クラス 🕸️
これらは実装ではなく契約を定義する。逆エンジニアリングでは、実装とインターフェースを混同しやすい。
- 次のキーワードを確認する:
interfaceキーワード、または抽象メソッド定義。 - 図面上で明確にマークする(通常、ステレオタイプ <<interface>> を使用)。
- 複数のクラスが同じインターフェースを実装し、収束点となることに注意する。
2. ジェネリクスとテンプレート 📦
現代の言語は、柔軟なクラスを作成するためにジェネリクスを使用する。List<String>はList<Integer>.
- UML ダイアグラムでは、これを生タイプ(例:単に”)に簡略化することがよくあります。
List). - 必要に応じて、特定の型制約を示すために注釈やステレオタイプを追加してください。
- ロジックに不可欠でない限り、すべてのジェネリックパラメータでダイアグラムを煩雑にしないでください。
3. 動的型付けとリフレクション 🔄
動的型付け言語では、型はコンパイル時に常に知られているわけではありません。リフレクションにより、コードは自身を検査できます。
- これにより静的解析が困難になります。変数に異なる型が割り当てられているのを目にすることがあります。
- 主要な型を推測するために、最も一般的な使用パターンを探してください。
- 型が曖昧な場合は、コード内のコメントを使用して意図を明確にしてください。
4. フレームワークとライブラリ 📚
コードは外部フレームワークに大きく依存することがよくあります。フレームワーク全体をダイアグラム化したくはないでしょう。
- 標準ライブラリ(例:IO、Math、文字列ユーティリティ)は無視してください。
- プロジェクトがフレームワークから拡張または実装しているクラスに焦点を当ててください。
- 外部依存関係には「ブラックボックス」表現を使用して、ダイアグラムを清潔に保ってください。
保守とリファクタリングへのメリット 🛠️
なぜリバースエンジニアリングの労力をかけるのでしょうか?即座のメリットはドキュメント作成ですが、長期的な価値はシステムの健全性にあります。
1. 結合の問題の特定 🎯
高い結合度はシステムを脆弱にします。ある部分が壊れると、多くの他の部分も壊れます。クラス図はこれを視覚的に明らかにします。
- 入力矢印が多すぎるクラスを探してください。これらは「ゴッドクラス」です。
- クラスが相互に循環的に依存している緊密なループを特定してください。
- これらの洞察を使用して、リファクタリングの取り組みを計画してください。
2. オンボーディングの促進 🎓
新しい開発者が加わると、コードを読むのは時間がかかります。図を読むのは速いです。
- 生成された図を最初のステップのリソースとして提供してください。
- まずコアモジュールを強調し、次に周辺モジュールを強調してください。
- アーキテクチャを理解するまでの時間を短縮してください。
3. レガシーシステムの近代化の支援 🔄
古い言語から新しい言語へ移行する際、ロジックを維持する必要があります。
- UMLモデルは、言語に依存しない仕様として機能します。
- このモデルを新しい言語構造に変換することができます。
- これにより、移行中にビジネスロジックが失われることがありません。
課題と制限 ⚠️
このプロセスは強力ですが、完璧ではありません。逆エンジニアリングでできないことを理解しておく必要があります。
1. 文脈の喪失
クラス図は構造を示しますが、動作は示しません。操作の順序や、時間を通じたデータのフローも示されません。
- 動作を理解するにはシーケンス図が必要です。
- コメントやロジックの説明はモデルに捕捉されません。
- 状態機械は、複雑な if-else ブロックの中に隠れていることがよくあります。
2. 命名の曖昧さ
コードでは暗号的な変数名が頻繁に使用されます。名前を変更しない限り、図はこれらの不適切な名前を反映します。
- 逆エンジニアリング中の名前変更は、判断に委ねられる部分です。
- 元の名前を維持し、それらを説明する注釈を追加する方が安全です。
- 名前のリファクタリングは、図だけでなくコード上で行われるべきです。
3. 拡張性
大規模なシステムでは、画面で読み取れないほど巨大な図が生成されることがあります。
- クラスターリングを使用して、関連するクラスをグループ化してください。
- 一つの巨大なマップではなく、特定のビュー(例:「データベースビュー」、「UIビュー」)に焦点を当ててください。
- 図は現実の完全な鏡ではなく、現実の一部(サブセット)であることを受け入れてください。
正確なモデリングのためのベストプラクティス ✅
逆エンジニアリングで生成した図が有用であるためには、以下のガイドラインに従ってください。
- 一貫性:全体を通して同じ記法スタイルを使用してください。同じ関係タイプに対して実線と破線を混用しないでください。
- 抽象化:すべてのメソッドを含めないでください。関連するメソッドをグループ化するか、ビューを煩雑にする場合はゲッター/セッターを省略してください。
- 検証:図とコードを相互に照合してください。コードが変更された場合は、図も更新してください。
- 自動化:可能であれば、ツールを使用して初期ドラフトを生成してください。手動での描画だけに頼らないでください。
- ドキュメント:ビジュアルモデルでは表現できない複雑なロジックを説明するために、図に注釈を追加してください。
ロジックの可視化に関する最終的な考察 💡
コードからの UML リバースエンジニアリングは、抽象的な設計と具体的な実装をつなぐ架け橋です。これには忍耐と細部への注意が必要です。関係性、可視性、構造を理解することで、複雑なシステムを制御する力が得られます。
目標は完璧さではなく、明確さです。少し不完全な図でも、図がないよりはましです。小さく始めて、コアクラスに焦点を当て、依存関係を理解するにつれて拡張してください。このアプローチは、長期的な開発を支える持続可能なドキュメント作成の慣行を築きます。
覚えておいてください。コードが真実であり、図は地図です。地図が領土と一致していることを確認してください。一貫した努力を続ければ、コードが時間とともにどのように進化しても、アーキテクチャを明確に把握し続けることができます。

